開発ノウハウ
対話型AIエージェントの構築方法について
公開日|2025.1.6
近年、対話型AIエージェントの技術が急速に進化しています。本記事では、対話型AIエージェントの基本的なアーキテクチャをもとに、具体的な構築方法を紹介します。
対象とする対話型AIエージェント
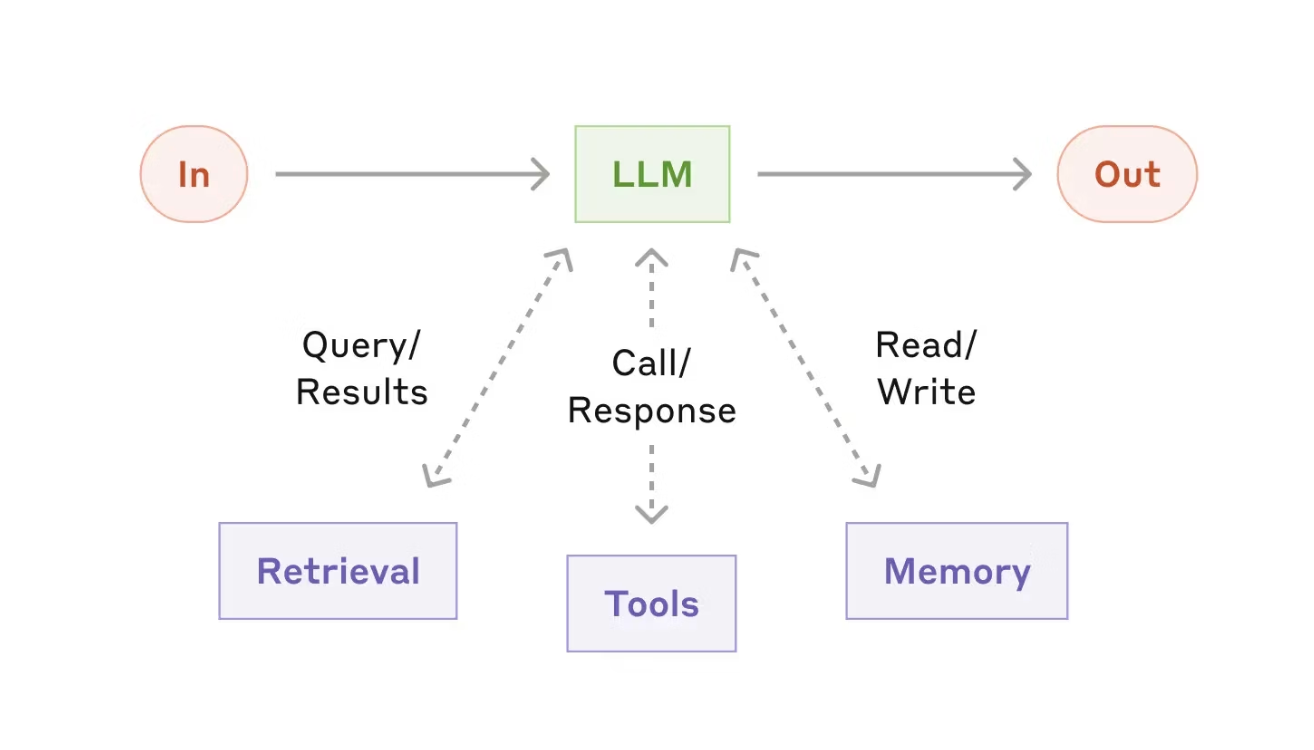
Anthropicのドキュメント「Building Effective Agents」で述べられている構築方法のうち、本記事が対象とするのは 「LLMがユーザとの対話のなかで自律的にツールや記憶を使い、問題解決を行うエージェント」 です。
対話型AIエージェントにはチャットボットと音声ボットの両方が考えられますが、本記事では 音声対話型のシナリオも含めて 想定します。
下図のように、ユーザとの対話を軸としてLLMが自律的にツール(外部APIやDB)を呼び出す、あるいは記憶(コンテキスト)を参照しながらゴールに向かってタスクを完了するアーキテクチャを念頭に置きます。

引用: Anthropic - Building Effective Agents
対話型AIエージェントの全体構成
対話型AIエージェントを構築する際、大きく3つのコンポーネントに分けて考えると整理しやすくなります。
-
ボイスボット(またはチャットボット)
-
ツール(Web API)
-
事後処理
以下では、これらそれぞれがどのように連携し、全体システムとして対話型AIエージェントを機能させるかを見ていきます。
1. ボイスボット(チャットボット)
ボイスボットの場合、音声認識と音声合成が必須となります。実装パターンとしては、
-
STT(音声認識) → LLMによる生成 → TTS(音声合成)
-
Speech to Speechモデル(OpenAI等のRealtime APIのようなモデル)
のいずれかです。一方、チャットボットの場合はテキストの入出力になるので、よりシンプルに構成可能です。
2. ツール(Web API)
AIエージェントがタスクを行うために、外部データを参照したり、外部APIを呼び出したり、独自のロジックを実行するためのAPI群を用意します。AnthropicではMCPというインターフェイスの利用を推奨しており、それに則ることでエージェントがツールを呼び出しやすくなります。
ツール内部では、
-
外部APIの実行
-
ロジックの実行
-
データベースの参照/書き込み
などを行います。また、ツール内部でも追加のAIエージェントやLLMを組み込むことでより高度な処理を実装することも可能です。
3. 事後処理
対話が終了した時点、または対話が中断したタイミングで自動的に実行される処理です。Webhookなどで会話ログを受け取り、主にLLMでの分析・データ抽出・分類を行います。たとえば、
-
会話のカテゴリ推定(クレーム、新機能要望、サポート要請など)
-
構造化したデータをCRMに登録
-
緊急度に応じて担当者に通知(SMSやSlackなど)
といった処理をここで行います。AIエージェントに100%の業務を任せるのは現実的でないケースが多いため、人間側が後工程でカバーできるようにするのがポイントです。
詳細アーキテクチャ
下図は、上記の3つのコンポーネントをどのようにつなげるかを表しています。

1、ボイスボット(チャットボット)
ユーザとのインターフェイス。音声/テキストいずれかの形でLLMとのやりとりを行う。
2、ツール(Web API)
ユーザの要望や質問に応じ、AIエージェント(LLM)が自律的に呼び出す機能群。DBアクセス外部サービス呼び出しロジック処理 など
3、事後処理(LLM + Webhook)
会話終了時に会話ログを受け取り、事後分析・処理を実行。会話内容のテキストマイニング分類や要約などのLLM処理担当者へのアラート送信 など
構築における3つの要諦
対話型AIエージェントを構築するときに特に重要になるポイントとしては、以下の3点が挙げられます。
-
プロンプト
抽象的なゴールや行動規範を自然言語で設定し、エージェントに指示する。事前にきっちりとワークフローが定義できるのであれば、AIエージェントではなく通常のシステム開発(ワークフロー+RPAなど)で対応するほうが無難です。「製品についての質問にはWebで検索し回答」「クレームが来たら折り返し連絡先を聞く」「新機能要望は詳しくヒアリングする」など、高度なタスクを抽象化してシンプルに書きます。
-
ツール設計
ツールはAPIとして整理し、“LLMが呼び出しやすい形” にします。APIが複雑すぎると、LLMが呼び出しパラメータやエンドポイントを間違える可能性が高くなります。特に音声対話環境ではユーザの本人確認が難しいケースが多い。例えば電話番号のみでユーザを判別する場合、それに対応したAPI設計が必要。
-
事後処理
AIエージェントが全てを完結させられるわけではないので、会話ログの分析や必要に応じた担当者アサインなどの後処理を自動化し、人間のオペレータへ引き継げる体制が大切。会話ログをWebhookなどで取得し、LLMでメタ情報(カテゴリなど)を推定したのちCRMやIssue管理システムに登録すると運用がスムーズになります。
対話型AIエージェントの具体構築例
先ほどのポイントを踏まえた、対話型AIエージェント構築のサンプルを示します。
詳細なソースコードやデモが以下で公開されているので、実装の参考にしてみてください。
https://zenn.dev/yuno_miyako/articles/e2c02be1d73f7b
-
プロンプトの設定
「製品についての質問が来たらWebで調べて回答する」「クレームがあったら折り返しの連絡先を聞く」「新機能要望であればヒアリングをする」など設定
-
ツールの用意
GeminiのWeb検索APIをエージェントツールとして構築。
-
事後処理
会話終了時に会話ログを取得し、スプレッドシートへの記録やカテゴリ分類を実施。新機能要望のカテゴリであればGitHub Issueを自動作成、クレームの場合はSMS通知を担当者に送る、といった分岐を定義。
LangCore Voicebotを使った高速開発・PoC
上記のように対話型AIエージェントを構築するには、音声認識や音声合成、ツール連携、事後処理など、さまざまな機能を開発・運用する必要があります。そこで「LangCore Voicebot」を使うことで高速にPoCを行い、すぐにサービスインする事例が増えています。
LangCore Voicebotの特徴
1、プロンプト設定が自然言語ベース
UIからエージェントの方針を自然言語で入力するだけで、簡単にLLMを制御できます。

2、ツール連携がOpenAPI仕様ベース
ツールとなるAPIのOpenAPI仕様書を登録するだけで、LLMから自動的に呼び出し可能。

3、事後処理もWebhookでカスタマイズ
会話終了時にWebhookが飛んでくるので、そのデータを受け取って自由に処理を実装できます。

4、進化し続ける音声技術への対応
音声認識・音声合成・LLM・Speech to Speechモデルなど、進化のスピードが速い分野であるため自前で構築することは大変な領域です。LangCore Voicebotでは内部設定を切り替えるだけで対応することができます。またOEM開発の事例も多いため、ゼロベースから構築するより圧倒的に手軽かつ安全に行うことができます。

まとめ
対話型AIエージェントを構築するうえで重要なのは、
-
「抽象的なゴールをもったプロンプト」 と 「LLMが使いやすいツール(API)」 をしっかり用意すること
-
事後処理を設計して、最終的なタスク完了を人間と協調して担保すること
です。とりわけボイスボットの分野は、音声合成や音声認識、Speech to Speechモデルなど、テクノロジー進化のスピードが非常に速いので、PoC段階から変化に追随しやすいアーキテクチャを採用すると良いでしょう。
LangCore Voicebotのようなプラットフォームを活用すれば、必要なコンポーネントを短期間で構築できるため、企業のPoCから本番運用移行もスムーズになります。
これから対話型AIエージェントを導入・開発される方の参考になれば幸いです。ぜひ気軽に取り組んでみてください。
宣伝
LangCoreでは「1時間の無料相談」を承っております!「生成AIでこんなことをやってみたいが、できるか?」「何か生成AIでできそうなことを探している」など、まずはお気軽にお問い合わせください。弊社の生成AIのプロ集団が、あらゆる分野と規模のビジネスに合った生成AIやChatGPTを使用したご提案をいたします。。→こちらで無料相談を予約する
開発ノウハウの関連記事
開発ノウハウ
おすすめAI開発環境!初心者向けからプロ仕様まで徹底比較
AI技術は、私たちの生活の様々な場面で活用され、近年目覚ましい発展を遂げています。自動運転、医療診断、顧客サービスなど、AIの応用範囲は広がる一方です。そして、このAI開発を支えているのが「AI開発環境」です。
記事を読む
開発ノウハウ
ボイスボットでOpenAI Realtime APIを使うべきか?
OpenAIがRealtime APIを発表
記事を読む
開発ノウハウ
ChatGPTを社内データで学習させる方法と注意点|機密情報漏洩リスク対策も解説
ChatGPTは、高度な自然言語処理能力を持つAIチャットボットとして、様々なビジネスシーンで活用が期待されています。特に、DX推進においては、業務効率化や新たな価値創出の強力なツールとなる可能性を秘めています。
記事を読む